Todo mundo concorda que PostgreSQL precisa de alta disponibilidade. Bem menos times realmente têm, porque a distância entre "temos uma réplica" e "a aplicação continua gravando quando uma máquina morre" é preenchida por decisões que ninguém quer tomar às 3 da manhã: quem é o primário agora, como a aplicação encontra ele, e como evitar terminar com dois. Nós construímos essa camada, rodamos, quebramos de propósito, e hoje estamos liberando.
Gratuito e open source, licença MIT: github.com/johnvithera01/postgresql-patroni-ha — um cluster PostgreSQL 17 completo em alta disponibilidade, com failover automático, laboratório Docker para aprender e scripts Ubuntu para produção. Documentação em Português e Inglês. Clone, quebre no laboratório, use. Dúvidas? Fale com a gente.
O problema que ele resolve
O banco precisa continuar aceitando gravações se uma máquina morrer, sem acordar ninguém. Com dois servidores PostgreSQL, replicação nativa e promote manual, três coisas dão errado exatamente no pior momento:
- Alguém precisa decidir quem é o primário. Uma decisão humana, sob pressão, com informação incompleta.
- A aplicação precisa descobrir o novo endereço. Connection string fixada em um IP não faz failover; ela simplesmente falha.
- Uma partição de rede pode deixar você com dois primários. Os dois aceitam escrita, os dois se acham certos, e reconciliar a divergência depois é trabalho manual e com perda.
O repositório amarra essas peças usando componentes que já existem e são bem conhecidos, ligados da forma específica que os faz funcionar como um sistema só:
| Necessidade | Como é resolvida |
|---|---|
| Quem é o primário? | Patroni + etcd. Só um nó consegue segurar o leader lock. |
| Como a aplicação acha quem grava? | Keepalived (VIP) + HAProxy na porta 5000, com health check GET /primary. |
| Quem promove a standby às 3 da manhã? | O Patroni, sozinho, assim que o leader lock expira. |
| E se os dois nós de banco discordarem? | Um terceiro voto: a máquina witness, que roda só etcd. |
| Uma transação confirmada pode ser perdida? | Não. synchronous_mode_strict confirma o COMMIT só depois que a standby síncrona tem o WAL. |
A arquitetura em uma imagem
Um único modelo de HA: Patroni. Não existe caminho de promote manual, nem reconstrução artesanal com pg_basebackup, nem modo duplo "às vezes automático, às vezes não". O Patroni elege o primário, promove a standby e reconstrói um membro quebrado.
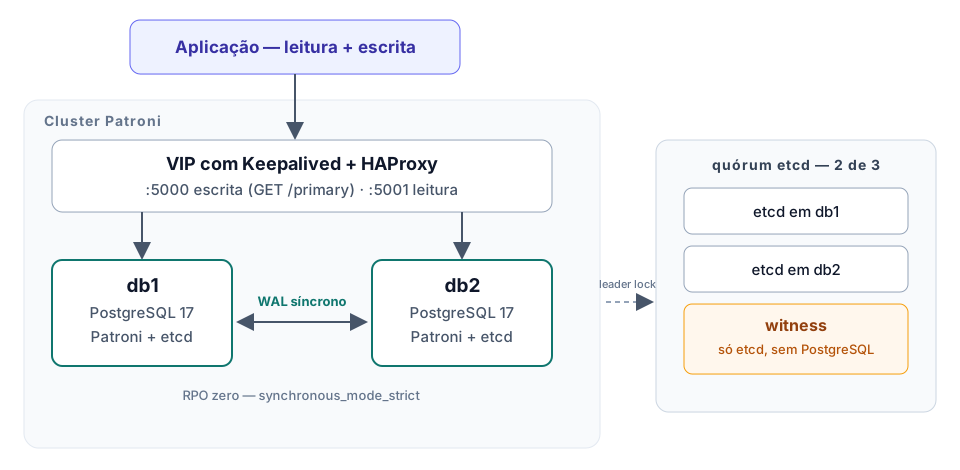
db1 e db2, com o leader lock decidido por um quórum etcd de três votos.| Peça | Onde roda | Papel |
|---|---|---|
| PostgreSQL 17 | db1, db2 | O banco, com wal_level=replica. |
| Patroni 4.1 | db1, db2 | Supervisor do PostgreSQL: bootstrap, réplica, promote, rewind e reinit. |
| etcd 3.5 | db1, db2, witness | Guarda a configuração do cluster e o leader lock. Quórum de 2 em 3. |
| witness | máquina própria | O terceiro voto. Sem PostgreSQL. Sem ele, dois nós de banco empatam. |
| HAProxy | db1 e db2 | Manda escrita só para quem responde 200 em /primary. |
| Keepalived | db1 e db2 | Anuncia um VIP, para a aplicação nunca precisar do IP de cada VM. |
| watchdog | db1, db2 | Reinicia o nó que perde o lock e não consegue se rebaixar a tempo. |
O witness é a peça que todo mundo tenta pular, e é justamente a que separa um cluster de um cara ou coroa. Com dois votantes, uma partição de rede resulta em 1 contra 1: nenhum lado consegue provar que tem a maioria, então nenhum pode assumir como primário com segurança. O terceiro etcd — em uma VM minúscula, sem banco nenhum — desempata de forma determinística.
Uma camada de replicação, de propósito
db1edb2formam um único escopo Patroni (pg-ha).- O líder aceita escritas; a standby aplica WAL por um slot físico com o nome do membro.
synchronous_mode: trueesynchronous_mode_strict: true: oCOMMITespera a standby síncrona.- A standby atende consultas somente leitura na porta
:5001do HAProxy (hot_standby=on). - Watchdog no Ubuntu: se o Patroni perde o lock e não consegue rebaixar o PostgreSQL a tempo, o nó reinicia sozinho.
RPO zero tem preço, e ele não é negociável. Com synchronous_mode_strict, se a standby síncrona estiver fora, as novas escritas param. Esse é o trade-off, não um defeito: o cluster se recusa a confirmar um commit que não consegue garantir. Se a sua prioridade é "continuar gravando mesmo sozinho", este desenho é o errado para você — e o README diz isso com essas mesmas palavras.
Por que removemos a camada de replicação lógica
A primeira versão carregava uma segunda preocupação: um servidor central somente leitura alimentado por failover slots do PostgreSQL 17, com publication, subscription e callbacks de troca de papel. Funcionava. Removemos mesmo assim, e o raciocínio vale mais do que o código valia.
Alta disponibilidade e replicação lógica são problemas diferentes que por acaso dividiam um repositório. Carregar os dois custava mais do que arquivos: forçava wal_level=logical em produção, somava apply workers e — o ponto que realmente importava — os testes do laboratório mediam continuidade lógica em vez de medir failover. O projeto dizia ser um cluster HA sem testar a única coisa que um cluster HA precisa provar.
A remoção levou junto oito scripts e cerca de 1.400 linhas, e deixou a configuração voltar ao que o streaming físico realmente precisa:
| Parâmetro | Antes | Agora | Motivo |
|---|---|---|---|
wal_level | logical | replica | ninguém mais decodifica WAL logicamente |
max_replication_slots | 40 | 20 | só os slots físicos dos membros |
sync_replication_slots | on | removido | sincronizava o slot lógico na standby |
max_logical_replication_workers | 10 | removido | sem apply workers |
max_worker_processes | 16 | removido | volta ao padrão |
callbacks | on_role_change | removido | existia para limpar slot órfão |
A standby continua respondendo consultas somente leitura na :5001. Se você precisa de uma cópia analítica separada, acrescente replicação lógica por conta própria — de forma deliberada, com parâmetros e testes próprios — em vez de herdá-la de um cluster cujo trabalho é sobreviver a uma máquina morta.
Teste em cinco minutos: o laboratório Docker
O cluster inteiro — três nós etcd, dois nós Patroni/PostgreSQL e o HAProxy — sobe em uma máquina só com Docker Compose. Ele existe para você quebrar as coisas de propósito antes de ser responsável por elas em produção.
git clone https://github.com/johnvithera01/postgresql-patroni-ha.git
cd postgresql-patroni-ha

./scripts/lab/reset-lab.sh    # constrói e sobe o cluster inteiro
./scripts/lab/status.sh       # quem é líder, quem é standby síncrona
./scripts/lab/setup-app.sh    # um banco e uma tabela para gravar
Os requisitos são apenas Docker Compose v2 e Bash. O que sobe:
| Serviço | Papel | Porta no host |
|---|---|---|
etcd1, etcd2, etcd3 | Quórum — etcd3 é o witness | interna |
db1, db2 | Patroni + PostgreSQL 17 | interna |
haproxy | escrita / leitura | 127.0.0.1:15000 e :15001 |
psql "host=127.0.0.1 port=15000 user=postgres dbname=appdb"   # escrita
psql "host=127.0.0.1 port=15001 user=postgres dbname=appdb"   # leitura
Agora quebre de propósito
Ler sobre failover não ensina nada. Ver um líder morrer com uma sessão de escrita aberta ensina muito:
./scripts/lab/test-switchover.sh   # promoção planejada e controlada
./scripts/lab/test-failover.sh     # mata o líder e acompanha a eleição
./scripts/lab/test-ha.sh           # o teste completo: reset + switchover + kill
O test-failover.sh mata o container do líder e então verifica três coisas: que o Patroni promoveu a standby sozinho, que a linha já confirmada sobreviveu à promoção, e que o HAProxy :5000 voltou a aceitar escritas. Toda escrita dos testes passa pelo HAProxy — nenhum teste fixa qual nó é o primário, porque num failover de verdade você também não sabe.
== Killing leader db2; db1 must take over with no operator action ==
 Container postgresql-patroni-ha-db2-1  Killed
automatic promotion succeeded: leader=db1
committed row before-kill-1786624502 survived the promotion (RPO zero)
== Restarting db2 to restore RPO-zero writes ==
INSERT 0 1
Automatic failover completed. The cluster writes again through HAProxy :5000.
O laboratório não é produção. Não há Keepalived nem VIP (VRRP precisa de rede L2 de verdade), e todos os nós dividem o mesmo host, então uma falha do host derruba todos de uma vez. As senhas do laboratório estão em scripts/lab/lib.sh e são valores de demonstração — não leve nenhuma delas para lugar nenhum.
O bug que só apareceu rodando
Vale contar, porque é o tipo de falha que nenhuma checagem estática pega. Os testes reescritos passaram no bash -n e no ShellCheck. Na primeira execução real do laboratório, quebraram assim:
== Creating appdb through the HAProxy writer (leader=db2) ==
CREATE DATABASE
ERROR:  relation "public.ha_events" does not exist
LINE 1: INSERT INTO public.ha_events (marker) VALUES ('bootstrap')
O CREATE TABLE nunca chegou ao psql. A causa: docker compose exec -T herda o stdin do chamador. A função que descobre qual container está vivo roda dentro de uma substituição de comando — e essa substituição herdava o mesmo stdin, comendo o heredoc destinado ao psql antes que ele o lesse.
A correção é um redirecionamento, aplicado a toda sonda que pode ser chamada de dentro de um $(…):
# scripts/lab/lib.sh
- if dc exec -T "$service" true             >/dev/null 2>&1; then
+ if dc exec -T "$service" true </dev/null  >/dev/null 2>&1; then
Nenhum linter pega isso. Só rodar pega — que é exatamente por que o laboratório existe.
Produção no Ubuntu: três máquinas
Produção são três VMs, e cada script é idempotente o bastante para ser executado a partir de um checklist, não da memória:
| Nó | Software |
|---|---|
db1 | PostgreSQL 17, Patroni, etcd, HAProxy, Keepalived |
db2 | o mesmo |
witness | só etcd — uma VM pequena basta |
Decisões já embutidas nos scripts, para você não rediscutir sob pressão: PostgreSQL 17 com Patroni 4.1+, synchronous_mode_strict (RPO zero), TLS no etcd e no PostgreSQL, watchdog obrigatório, e instalação limpa com restore em vez de conversão in-place de um cluster Debian existente.
# em db1, db2 e witness
sudo ./ubuntu/install-env.sh ubuntu/env.example
sudo nano /etc/pg-patroni-ha/env
sudo bash ubuntu/patroni/setup-etcd.sh

# witness
sudo bash ubuntu/patroni/setup-witness.sh

# db1 e db2
sudo bash ubuntu/patroni/setup-patroni-node.sh
sudo bash ubuntu/patroni/bootstrap-cluster.sh   # só no primeiro nó
sudo bash ubuntu/patroni/join-replica.sh        # segundo nó
sudo bash ubuntu/patroni/apply-dcs-tuning.sh    # só no líder atual
sudo bash ubuntu/patroni/setup-haproxy.sh
sudo bash ubuntu/patroni/setup-keepalived.sh
sudo bash ubuntu/monitor/install-cron.sh
O apply-dcs-tuning.sh grava configuração no etcd para o cluster inteiro, então ele pertence ao líder atual — rodar nos dois nós não é "mais seguro", é redundante.
Os certificados vão em /etc/pg-patroni-ha/tls/ antes de rodar qualquer coisa. A lista SAN do certificado do PostgreSQL precisa incluir o hostname do VIP e os hostnames dos dois bancos — senão a aplicação valida bem contra um nó e falha na verificação assim que cair no outro, ou seja, durante o seu primeiro failover real.
O runbook completo é o docs/production.md; o raciocínio por trás do modelo de replicação, do quórum e do que o projeto explicitamente não faz está em docs/architecture.md.
Operação do dia a dia
sudo bash ubuntu/patroni/status.sh             # estado do cluster, lag, quem lidera
sudo bash ubuntu/patroni/switchover.sh db2    # planejado, em janela de manutenção
sudo bash ubuntu/patroni/failover.sh db2      # forçado, quando o líder já se foi
sudo bash ubuntu/patroni/reinit-member.sh db1 # reconstrói um membro a partir do líder
sudo bash ubuntu/monitor/check-all.sh         # as verificações de cron
Use o switchover.sh quando o líder atual está saudável e você escolhe a hora — o Patroni só troca se o candidato já for a standby síncrona no DCS, então ele recusa as movimentações que perderiam dados. Use o failover.sh apenas quando o líder já se foi e o Patroni não agiu sozinho; se o Patroni está funcionando, você nunca vai precisar dele.
Depois de um crash, o nó antigo normalmente volta via pg_rewind. Quando o rewind não é possível, o reinit-member.sh clona aquele membro a partir do líder atual — mais lento, mas sempre correto.
Os limites, ditos de cara
Um desenho de HA que não diz onde quebra é propaganda. Estes são trade-offs deliberados, documentados no próprio repositório:
- RPO zero trava as escritas quando não há standby síncrona. Troca-se disponibilidade de escrita por nunca perder um commit confirmado.
- Perder o witness e um nó de banco ao mesmo tempo perde o quórum. O sobrevivente não tem o lock e não vai se promover. Isso é intencional — um nó sozinho que não consegue provar que está sozinho é exatamente como o split brain começa.
- Replicação não é backup. Um
DELETEreplica fielmente e na hora. Use pgBackRest, ou equivalente, para PITR. - Keepalived/VRRP precisa de rede L2 real. O laboratório Docker não exercita o VIP; valide isso nas VMs de verdade.
- O HAProxy termina o TCP, então o PostgreSQL vê o IP do proxy, não o do cliente. Restrinja o CIDR da aplicação no firewall e no HAProxy, não só no
pg_hba.conf. - Isto é HA local, em uma rede L2. Sobrevive a uma máquina morta, não a um site morto. Disaster recovery entre regiões é outro desenho.
- Ele não migra um cluster de produção existente in-place. Ele sobe um cluster novo, restaura um backup validado no líder e depois junta a standby.
Failover automático não é monitoramento
Um cluster Patroni sobrevive à falha. Ele não conta por que ela aconteceu, e vai sobreviver alegremente à mesma falha toda semana sem ninguém perceber que um disco está enchendo, que um membro foi reinicializado três vezes no mês ou que a standby síncrona atrasa sob a carga da tarde.
Pior: as partes desse desenho que protegem você são também as que machucam em silêncio. Uma escrita travada por synchronous_mode_strict parece "a aplicação está lenta", não "a standby sumiu". Um replication slot deixado para trás por um membro que nunca voltou retém WAL até o pg_wal encher o filesystem e o cluster inteiro parar — a forma mais comum de um servidor PostgreSQL perfeitamente saudável cair. Lag de replicação que dispara às 3 da manhã e normaliza às 7 é invisível para quem só olha depois da reclamação.
Essa é a camada que o PG Monitoring cobre: acompanhamento contínuo de lag e retenção de slots, crescimento de WAL, autovacuum e risco de wraparound, regressões de query, saturação de conexões e esperas por lock — com histórico, para que depois de um failover você prove o que aconteceu em vez de adivinhar. Use o cluster open source para ficar de pé; use monitoramento para não ser o último a saber por que quase não ficou.
Use, quebre, pergunte
O repositório é licenciado em MIT. Clone, faça fork, rode o laboratório, desmonte, adapte os scripts ao seu ambiente. Issues e pull requests são bem-vindos — a CI valida Bash e ShellCheck, confere o arquivo Compose e roda o test-ha.sh completo, então uma mudança que quebra o failover não entra sem alarde.
Repositório: github.com/johnvithera01/postgresql-patroni-ha — README em Português · README in English
Travou, ou quer uma segunda opinião sobre a sua topologia antes de montar? Fale direto conosco:
WhatsApp: +55 62 98156-1666
E-mail: joao.victor.32@hotmail.com
Respondemos dúvidas sobre o repositório sendo você cliente do PG Monitoring ou não. Desenhar HA errado custa caro o bastante para preferirmos que você acerte.
Referências: o manual do PostgreSQL documenta replicação síncrona, hot standby, pg_rewind e replication slots. A documentação de modos de replicação do Patroni explica o synchronous_mode_strict em detalhe.